
教師あり学習って何? それは「問題と正解のセットでAIを鍛える手法」です!
こんにちは!
IT・プログラミング関連講師の荒川栄一郎です。
本日は「強化学習」について記述します。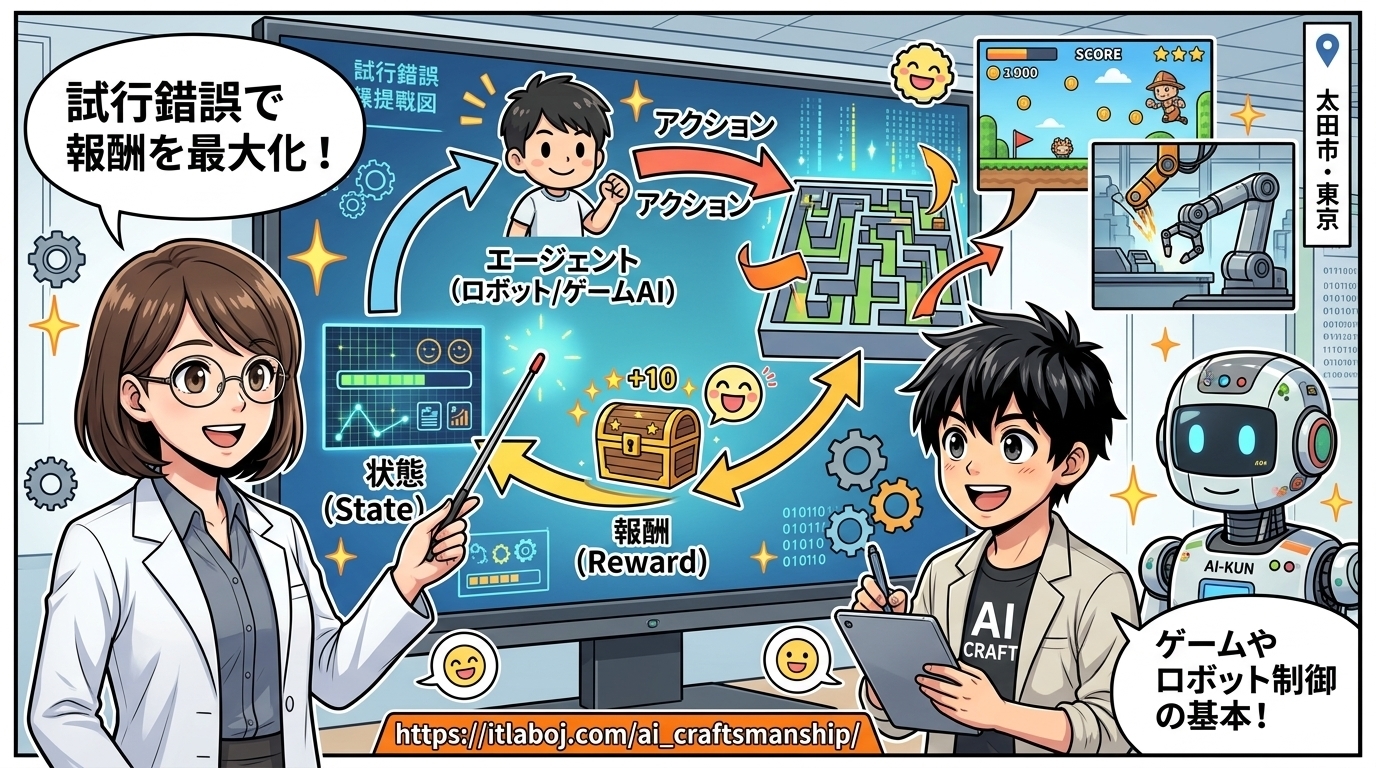
★はじめに:自らチャレンジして勝手に上達するAI!?
「囲碁の世界チャンピオンを打ち破ったAI」
「ゲームのルールだけ教えて放っておいたら、人間を超えて無敵になったAI」
「複雑な道路状況を判断して走る自動運転車」
これら最新AIの目覚ましいニュースの影には
必ず共通する重要な技術が存在します。
それこそが
今回ご紹介する「強化学習(Reinforcement Learning)」です。
前回までのコラムでは
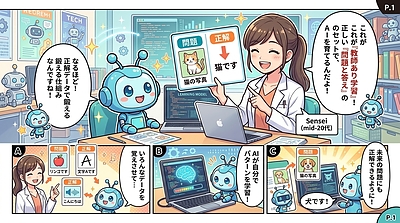
問題と答えのセットで学ぶ「教師あり学習」や
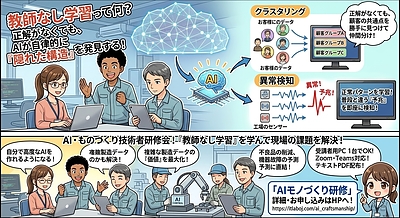
正解なしでデータのグループ分けを行う「教師なし学習」をご紹介しました。
これらは主に「データの分析・分類・予測」を得意とする手法です。
しかし
強化学習が挑むのは「判断と行動の最適化」です。
タイトルにある通り
強化学習とは一言で言えば
「試行錯誤を繰り返しながら、スコア(報酬)を最大化する最適な行動パターンを自力で覚えていく仕組み」
です。
人間があらかじめ答えを教えなくても
AI自身が環境の中で動き回り
失敗と成功を重ねながら自発的に「神業レベルのコツ」を掴んでいく——。
今回は
そんな夢のような技術である「強化学習」の基本から
ものづくり現場での活用例、そして実際にAIを作れるようになるためのアプローチを徹底解説します!
★強化学習の基本仕組み:まるで「自転車の練習」や「ゲームの攻略」!
「試行錯誤で覚える」と言われても
プログラムがどうやって学習していくのかイメージしにくいかもしれません。
最も分かりやすい例えは
私たちが子どもの頃に体験した「自転車の練習」や「テレビゲームの攻略」です。
自転車に初めて乗る時
誰もマニュアルの数式を読んで乗れるようにはなりませんよね。
●「右に傾いたらハンドルを右に切る」
●「スピードが出すぎたらブレーキをかける」
何度も転んだり(失敗)、少し長く進めたり(成功)する中で
脳と体が自然と「倒れないバランス」を覚えていきます。
強化学習も、まったく同じアプローチで学習します。
【強化学習を支える4つの重要要素】
強化学習のプログラム内では
以下の4つの要素がぐるぐると循環しています。
●エージェント(AI)
学習するプレイヤー(ロボットや車、ゲームの主人公など)。
●環境(Environment)
エージェントが活動する世界(チェス盤、工場内、シミュレーション空間など)。
●行動(Action)
エージェントが取るアクション(「右へ曲がる」「アームを下げる」「加速する」など)。
●報酬(Reward)
行動の結果に対して与えられる「ご褒美(プラス評価)」や「ペナルティ(マイナス評価)」。
エージェントは
「どうすれば将来もらえる『報酬の合計』が一番多くなるか?」ということだけを目的に
何万回、何百万回とシミュレーション空間で行動を繰り返します。
最初は壁にぶつかってばかりの不器用なAIが
繰り返すうちに「こう動けば壁を避けてハイスコアが取れる!」と気づき
人間には思いつかないような洗練された動きを身につけていくのです。
★なぜ今、製造業やものづくりの現場で「強化学習」が熱いのか?
ゲームや自動運転のイメージが強い強化学習ですが
実は日本の誇る「モノづくり・製造現場」において
今最も注目を集めている技術の一つです。
従来の産業用ロボットは
「10cm動いて、30度曲がって、部品を掴む」という動作を
人間がプログラミング(ティーチング)して動かしていました。
しかし
対象物の形が毎回違ったり、位置が数ミリずれていたりすると
途端に動かなくなってしまう課題がありました。
ここに強化学習を導入すると、現場に劇的な変化が起きます。
① ロボットアームの「バラ積みピック&プレイス」
乱雑に積まれた不規則な形状の部品を
ロボットアームが自ら
「どう掴めば落とさずに持ち上げられるか」をシミュレーション上で強化学習します。
失敗してもペナルティを与えて学習させることで
どんな角度の部品でもしなやかに掴める熟練工のようなロボットが完成します。
② プラント・工場のエネルギー最適化
化学プラントや大規模な工場の空調・電力制御は、外気温や稼働状況によって
パラメータを細かく調整する必要があります。
強化学習AIに運用を任せることで
最もエネルギー効率が良い(=電気代・CO2を最小化する)温度制御を自動的に探らしめ
大幅な省エネを実現できます。
③ 物流倉庫の自走ロボット(AGV)のルート最適化
多数の自動搬送ロボットが交錯する物流倉庫で
お互いに衝突せず、最短時間で荷物を運べる移動ルートを
各AIロボットがリアルタイムに学習・実行します。
★深層学習(ディープラーニング)との融合で「Deep Q-Network」へ進化した!
強化学習は昔からある理論ですが
近年の「ディープラーニング(深層学習)」と合体したことで爆発的な進化を遂げました。
この融合技術を「深層強化学習(Deep Reinforcement Learning)」と呼びます。
かつては単純な迷路ゲームくらいしか解けなかった強化学習が
ディープラーニングの「高度な画像認識力・空間把握力」を手に入れたことで
「カメラの映像を見ながら、リアルタイムで複雑な状況を判断して最適な行動をとる」という
人間顔負けの芸芸芸ができるようになったのです。
まさに
「データを見て判断する脳」と「試行錯誤して身体感覚を覚える脳」が合体した
AI進化の到達点と言えます。
★まとめ:理論を知ったら、自分の手で「動くAI」を作ってみよう!
今回は
次世代技術の核となる
「強化学習(試行錯誤で最適な行動を覚える仕組み)」について解説してきました。
①基本コンセプト
AI自身に行動させ、報酬(ご褒美)を最大化するように試行錯誤させる。
②構成要素
エージェント、環境、行動、報酬のループで成長する。
③現場での活躍
ロボット制御、プラント最適化、物流自動化など「動きや判断」を自動化する。
「AIが自分で試行錯誤して賢くなっていくなんて、本当に面白い!」
と感じていただけたのではないでしょうか?
これからの時代
製造業やIT業界で圧倒的な強みを持つエンジニアとは
ただAIの知識を語れる人ではありません。
Pythonなどの言語を使って環境を構築し
強化学習のライブラリ(Gymなど)を動かし
自社のロボットやシステムに組み込める実践力を持った人です。
「難しそうに思えるけれど、自分にもプログラムが書けるのだろうか?」
「現場の課題を解決するAIシステムを、ゼロから作ってみたい!」
そう思われた方は
ぜひ一度「AIモノづくり研修」の詳細をチェックしてみてください。
一歩踏み出せば、あなたの手で未来のモノづくりを動かす感動が待っています!
【AIモノづくり研修】
AIモノづくり研修の詳細については
ホームページに記載していますので参考にしてください。
●「AIモノづくり研修」の詳細情報
https://itlaboj.com/ai_craftsmanship/
●「AIモノづくり研修」の受講に必要なもの
このコースを受講するためには
1受講者に対してPCが1台あれば十分です。
オンラインで受講される方は
「Zoom」「Teams」などのオンラインツールが利用できる環境があればいいと考えます。
テキストは
IT研究所株式会社が作成したものをPDFで提供します。
必要なソフトウェアやセットアップの方法も
PDFで事前配布します。
みんなが楽しみながらIT・プログラミングの知識を習得してほしいと思いますし
将来のIT技術者を研修や動画コンテンツを通じて
育成していきたいと考えています。
私は日本全国に多くのIT技術者を育成できる研修を目指していきたいです。
そして一人でも多くの受講者に受講してもらい理解してもらえる研修を行いたいと思っています。