
ニューラルネットワークって何? それは「人間の脳の神経回路を計算で再現した仕組み」です!
こんにちは!
IT・プログラミング関連講師の荒川栄一郎です。
本日は「教師なし学習」について記述します。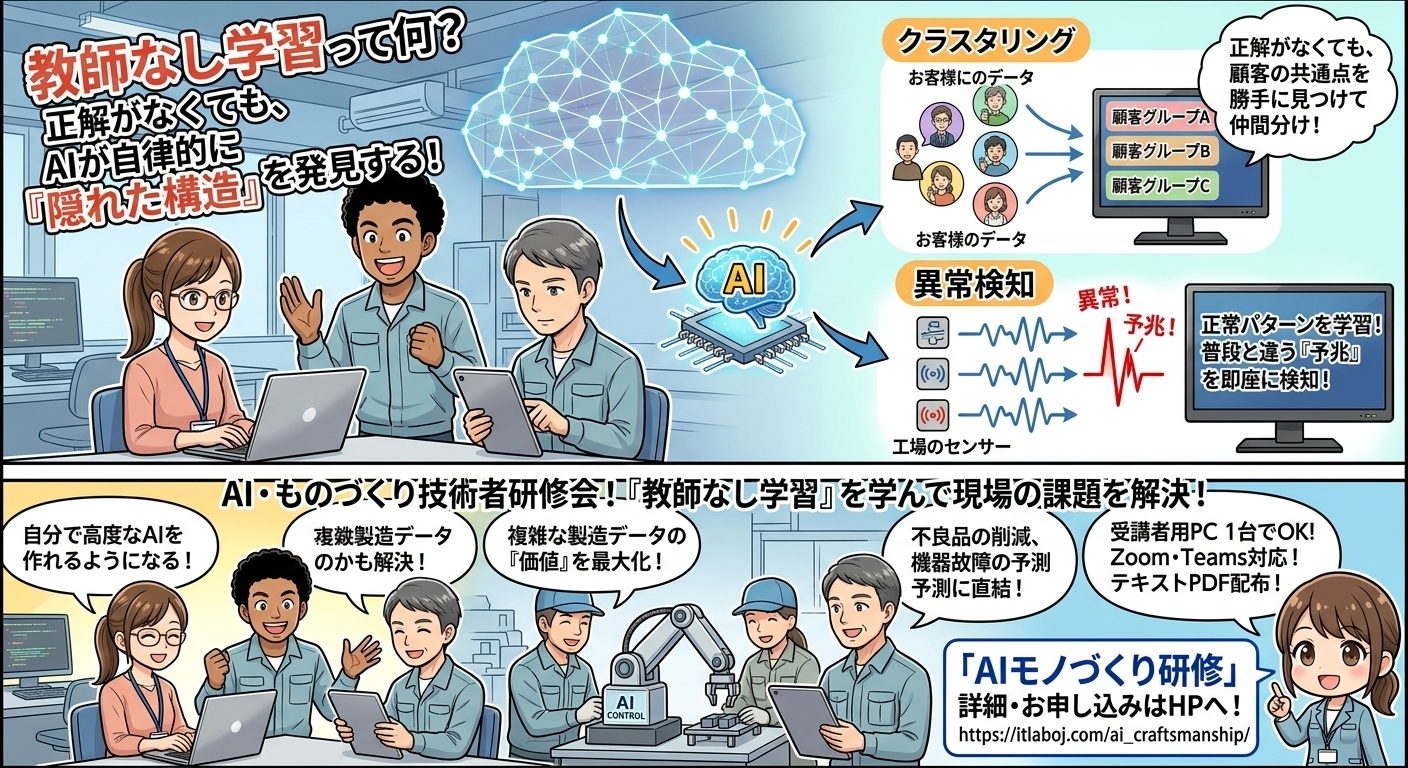
★はじめに:「正解がない世界」でAIはどうやって学ぶのか?
「AIに過去の売上データを与えて未来の数値を予測させる」
「カメラ画像に『良品』『不良品』のラベルを貼って判定させる」
前回のコラムでは
問題と答えのセットでAIを鍛え上げる「教師あり学習」をご紹介しました。
これは実務で最もよく使われる王道のアプローチです。
しかし
実際のビジネスやモノづくりの現場を見渡してみると
「そもそも何が正解なのか分からないデータ」や
「正解のラベルを1つずつ貼っていく時間も人手もない膨大なデータ」のほうが
圧倒的に多いのが現実ではないでしょうか?
●「自社サイトに訪れる数十万人の顧客を、特徴ごとにグループ分けしたいけれど、どんなグループが存在するのか分からない」
●「工場のセンサーデータから『いつもと何か違う不吉な予兆』を検知したいけれど、過去に一度も起きたことがない故障の正解データなんて存在しない」
こうした「正解のない課題」に対して絶大な威力を発揮するのが
今回ご紹介する「教師なし学習(Unsupervised Learning)」です。
タイトルにある通り
教師なし学習とは一言で言えば
「正解なしでデータの共通点や構造を探し出す手法」のことです。
「答えを教えていないのに、AIが勝手にデータの特徴を見つけて分類してくれる」という
一見すると魔法のようなこの仕組み。
今回は
その基本ロジックからビジネス現場での実用例
そして自ら構築できるようになるための学習ステップまでを分かりやすく紐解いていきます!
★教師なし学習の基本仕組み:データを整理整頓する「天才的な仕分け人」
教師なし学習の最大の特徴は
人間に例えるなら
誰も答えを教えてくれない中で
自力で部屋の散らかった大量の物を整理整頓する部屋の片付けに似ています。
人間はAIに対して「これが正解だよ」という答え(ラベル)を与えません。
膨大なデータだけを「はい、これ分析しておいて」とどさっと渡すだけです。
答えを持たないAIは
データ同士の距離や類似度(似ている度合い)を数学的にひたすら計算し始めます。
●データごとの特徴(数値やベクトル)を比較する
●「このデータとこのデータは、性質がすごく似ているな」というグループを見つける
●「このデータだけ、全体のどのグループからも極端に離れていて変だな」という異物を見つける
このように
AI自らがデータの背後に潜む「隠れた構造やパターン」を浮き彫りにしていきます。
人間が事前に意図や先入観(バイアス)を与えないからこそ
人間すら気づいていなかった「驚きの事実」をデータの中から発見してくれるのが
教師なし学習の醍醐味なのです。
★教師なし学習が得意な「3つの代表的なタスク」
教師なし学習が現場で威力を発揮する処理は
大きく分けて「クラスタリング」「異常検知」「次元削減」の3つがあります。
① クラスタリング(グループ分け)
正解のカテゴリが決まっていないデータを、
たもの同士で自動的にグループ(クラスター)に分ける技術です。
●マーケティングの顧客セグメンテーション
購買履歴や行動ログから
「夜間に特定のカテゴリだけを買う層」「割引時にまとめ買いする層」など
独自の顧客タイプを自動判別します。
●製品・素材の分類
化学組成や素材特性のデータから
似た性質を持つ素材グループを網羅的に分類します。
② 異常検知(アノマリー・デクション)
「何が異常か」を教えるのではなく
「正常な状態とは何か」を大量のデータから学ばせる手法です。
●工場の予防保全
正常稼働時の振動や音波データをAIに読み込ませておきます。
普段のパターンからわずかに外れた挙動(微小なガタつき)が起きた瞬間に
「普段と違う!」と警報を鳴らします。
故障が起きる前の「予兆」を掴むことができるため、製造ラインの停止を防げます。
●不正利用検知
クレジットカードの決済履歴から
普段の所有者の購買行動パターンから著しく逸脱した不審な決済をリアルタイムでブロックします。
③ 次元削減(データの要約・可視化)
数十〜数百種類もある複雑なデータの項目(変数)を
情報量を保ったまま2次元や3次元のグラフにギュッと圧縮・要約する技術です。
●複雑なデータの可視化
人間には理解できない多次元のパラメータ群を視覚的なグラフに変換し
全体の傾向をパッと見て把握できるようにします。
★なぜ「教師なし学習」がDXやビジネス変革の鍵を握るのか?
なぜ今
多くの企業が「教師なし学習」の導入に力を入れているのでしょうか。
そこには現実のビジネス現場が抱える切実な理由があります。
理由①:正解データを作るコスト(アノテーションコスト)がゼロになる
教師あり学習を行うには
人間が手作業で画像やデータに
「これは不良品」「これは猫」とラベルを貼り続ける作業(アノテーション)が必要です。
これには膨大な人件費と時間がかかります。
教師なし学習なら
溜まっている生データをそのまま投げ込むことができるため
データ準備のコストを大幅に削減できます。
理由②:人間の「先入観」を超えた発見ができる
人間が「うちのターゲット顧客は30代男性だ」と思い込んでいても
教師なし学習で顧客データを分析してみると
「実は50代女性と20代男性の特定の購買パターンが全く同じグループを形成していた」といった
人間の知覚を超えた新しい発見(インサイト)が得られます。
★まとめ:教師あり・教師なしを組み合わせる「AI活用力」を身につけよう!
今回は
正解のないデータから価値を生み出す
「教師なし学習(正解なしでデータの共通点を探す手法)」について解説してきました。
●基本コンセプト
正解ラベルなしで、データ同士の類似性やパターンをAIが自力で発見する。
●得意なタスク
データをグループ化する「クラスタリング」、予兆を掴む「異常検知」、要約する「次元削減」。
●ビジネスの強み
データラベル付けの手間がかからず、人間が気づかない隠れた法則を発見できる。
「教師あり学習(明確な判定・予測)」と
「教師なし学習(未知の発見・異常検知)」の特性を正しく理解し
現場の課題に合わせて使い分けたり組み合わせたりできるようになると
あなたの価値は一気に高まります。
AI時代に求められるのは
単に用語を知っていることではありません。
実際にPythonでプログラムを書き、データを読み込ませ
意図した通りのAIモデルを構築して結果を評価する力です。
「理論はわかったけれど、実際のコードはどう書くの?」
「自社のデータをどう扱えばAIが動くのか体験してみたい!」
そう感じた方は
ぜひ一度実践的な「AIモノづくり研修」で
自分の手でAIを組み上げる面白さを体験してみてください!
【AIモノづくり研修】
AIモノづくり研修の詳細については
ホームページに記載していますので参考にしてください。
●「AIモノづくり研修」の詳細情報
https://itlaboj.com/ai_craftsmanship/
●「AIモノづくり研修」の受講に必要なもの
このコースを受講するためには
1受講者に対してPCが1台あれば十分です。
オンラインで受講される方は
「Zoom」「Teams」などのオンラインツールが利用できる環境があればいいと考えます。
テキストは
IT研究所株式会社が作成したものをPDFで提供します。
必要なソフトウェアやセットアップの方法も
PDFで事前配布します。
みんなが楽しみながらIT・プログラミングの知識を習得してほしいと思いますし
将来のIT技術者を研修や動画コンテンツを通じて
育成していきたいと考えています。
私は日本全国に多くのIT技術者を育成できる研修を目指していきたいです。
そして一人でも多くの受講者に受講してもらい理解してもらえる研修を行いたいと思っています。