
AIでできることって何? それは「人間の可能性を極限まで広げる最強の相棒」です!
こんにちは!
IT・プログラミング関連講師の荒川栄一郎です。
本日は「過学習」について記述します。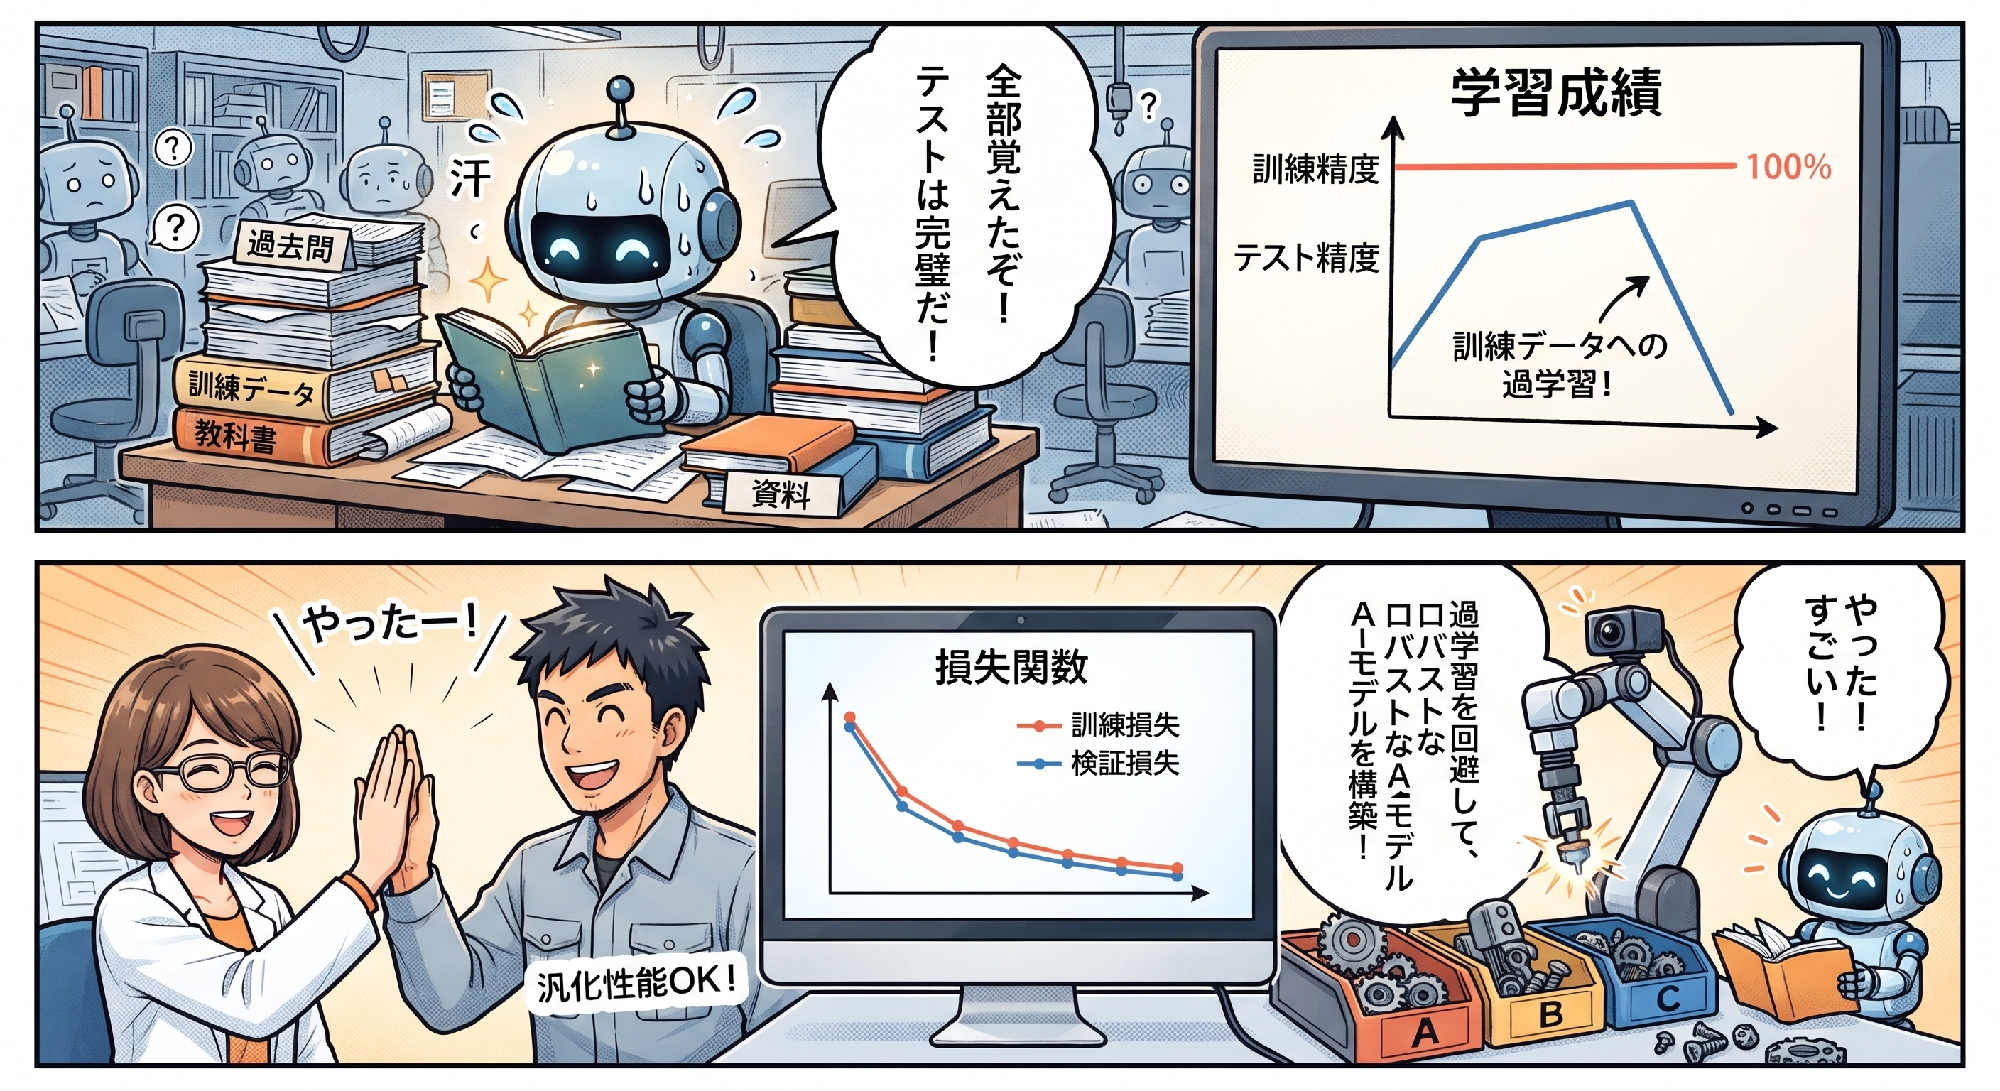
★はじめに:AIが「教科書」の丸暗記でテストに臨むとき
「AIに大量のデータを学習させて、テストデータで検証したら正解率が99%だった! すごい!」
「でも、いざ実際の現場で使ってみたら、全然使えない...。なぜ?」
マイベストプロのコラムや
私たちの「AIモノづくり研修」の現場でも
経営者や技術者の方々から、このような「AIの実力不足」に関する相談をよくいただきます。
これまでの連載コラムでは
AIの仕組み(ニューラルネットワークなど)や学習手法(教師あり・なし・強化学習)
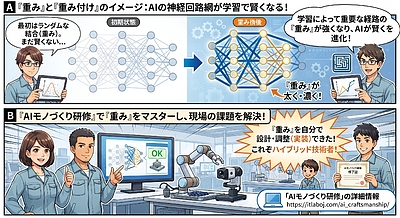
そして賢さを決めるパラメータである「重み」までを紐解きました。
AIはデータを学習することで賢くなりますが
その学習のさせ方を一歩間違えると
「見かけは賢そうだが、全く応用がきかない『使えないAI』」が出来上がってしまいます。
タイトルにある通り
この「応用がきかない」状態こそが、現代のAI開発における最大の敵であり
実務家が必ず乗り越えなければならない壁、「過学習(Overfitting)」です。
今回は
この過学習の正体を解き明かし
なぜそれが現代のモノづくり現場で独自の賢いAIを実装するために致命的なのか
そして研修でどう対策を習得できるのかを解説します!
★過学習とは何か?:優等生だけど、応用問題が解けないAI
過学習とは、一言で言えば
「AIモデルが、学習に使ったデータ(訓練データ)に対して『適合(学習)』しすぎてしまい
見たことのない新しいデータ(テストデータや実運用データ)に対する予測や判断の性能が
著しく低下してしまう現象」
のことです。
例えるなら
「教科書と過去問だけを完璧に丸暗記した学生」のようなものです。
過去問(訓練データ)と同じ問題が出れば、100点満点を取ります。
この時点では、AIは完璧な優等生に見えます。
しかし、少しでも数字や言い回しが変わった応用問題(新しいデータ)が出されると
途端に手も足も出なくなり、正解率がガクンと落ちます。
教科書の内容を理解しておらず、答えをそのまま覚えていただけだからです。
なぜ過学習が起きるのか?
前回のコラムで解説した「重み」の調整プロセスが、過剰に行われることが原因です。
AIは、学習データの中にある「本質的なルール」だけでなく
「その学習データにしか存在しない、ノイズ(雑音)や偶然の偏り」までをも
細かく覚え込んで(適合して)しまうのです。
その結果
AIの頭の中にある無数のスイッチ(重み)が
訓練データだけに特化したガチガチの設定になってしまい
少しでも状況が変わると柔軟に対応できなくなります。
★モノづくり現場で起こる過学習の具体例
この「丸暗記」の罠は
実際の製造現場やビジネスのデータ分析において、深刻なトラブルを引き起こします。
① 工場の不良品検知AIのケース
●訓練データ
過去1年分の「正常な製品」と「明らかな不良品」の画像データ。
●過学習したAI
AIは、製品のキズという本質的な特徴だけでなく
「そのカメラで撮影したときの、特定の照明の映り込み」や「背景にある作業台の傷」までを
不良品であるかのような特徴として学習してしまいました。
●現場での結果
検査対象の製品は完璧な良品なのに
背景の作業台が少し汚れていただけで、「不良品!」と誤判定してしまいました。
また、新しい照明に交換しただけで、全く機能しなくなりました。
② 部品の需要予測AIのケース
●訓練データ
過去5年間の販売データ。
特定の月のデータが、たまたま大きなイベントと重なり、異常に売上が高かった。
●過学習したAI
AIは、「経済情勢」や「季節変動」といった本質的な要因よりも
「特定の年の特定の月のイベント」という
そのデータにしか現れない偶然のパターンを重要視してしまいました。
●現場での結果
翌年、そのイベントは開催されなかったのに
AIは「去年と同じように爆発的に売れるはずだ!」と予測し
過剰な在庫を抱えることになりました。
③ 3D CADデータの自動設計AIのケース
●訓練データ
熟練設計者が作成した、特定の形状の製品データのみ。
●過学習したAI
AIは、荷重分散などの物理法則よりも
「熟練者が好む特定の曲線の形状やサイズ」を、ベストなデザインとして盲目的に学習してしまいました。
●現場での結果
少し異なる仕様の製品を設計させようとしても
いつも同じような、応用がきかない古臭いデザインの案しか出してきませんでした。
★過学習を防ぎ、現場で使える「汎用的なAI」を作る技術
「これなら、AIなんて怖くて使えない」と思われるかもしれませんが、ご安心ください。
AI技術者は、この過学習を防ぐための様々な技術(正則化手法)を編み出しています。
これらを駆使することで
「教科書を丸暗記するAI」から「教科書の根本的な原理を理解し、応用問題も解けるAI」へと
育て上げることができます。
【代表的な対策手法】
①学習データの量を増やす・多様化させる
単純にデータを増やすだけでなく、画像を回転・反転させたり、ノイズを加えたりする(データ拡張)ことで
AIが特定のデータに固執するのを防ぎます。
②モデルの複雑さを制限する
ニューラルネットワークの層を減らしたり、ノード数を減らしたりして
AIが細かすぎるノイズまで覚えられないようにします(シンプルにする)。
③正則化(Regularization)
学習中に、特定の「重み」が巨大になりすぎることにペナルティを課すことで
モデル全体を滑らかで柔軟な状態に保ちます(L1/L2正則化)。
④ドロップアウト(Dropout)
学習の途中で、ランダムに一部のニューロン(神経細胞)を無効化しながら学習させます。
これにより、AIが特定のニューロンの組み合わせに依存せず
ネットワーク全体で特徴を分散して覚えるように強制します。
⑤早期終了(Early Stopping)
訓練データに対する正解率は上がり続けているのに
テストデータに対する正解率が下がり始めた瞬間に、学習を強制終了します。
まさに、過学習が始まる直前でストップをかけます。
★まとめ:過学習の罠を回避し、独自の「使えるAI」を実装しよう!
今回は
AI開発の実務で最も注意すべき現象である
「過学習って何? それは『訓練データだけに適合しすぎる現象』です!」について解説してきました。
①過学習(丸暗記)
訓練データに適合しすぎてしまい、新しいデータに対応できない応用力のない状態。
②現場でのリスク
特定のデータ(ノイズや偶然)に反応してしまい、実運用では誤判定や的外れな予測を連発する。
③実践の重要性
フレームワーク任せの学習では防げないため、技術者が「データの特性」を見極め
「適切な対策手法(正則化など)」を自ら設計・実装するスキルが不可欠。
ブラックボックス化されたAIをただ動かすのではなく
なぜ過学習が起きるのかの仕組みを理解し
自社の現場のデータに合わせて『使えるAI』を自分の手で調整・実装してみたい!
そう思われた方にこそ、実践的な「AIモノづくり研修」をおすすめします。
数理の基礎から始まり、実際にPythonでニューラルネットワークを構築し
試行錯誤しながら過学習の兆候を見極め、対策を講じる
——その体験を通じて、あなただけの「現場で本当に役に立つAI」を形にする感動を体感してみませんか?
【AIモノづくり研修】
AIモノづくり研修の詳細については
ホームページに記載していますので参考にしてください。
●「AIモノづくり研修」の詳細情報
https://itlaboj.com/ai_craftsmanship/
●「AIモノづくり研修」の受講に必要なもの
このコースを受講するためには
1受講者に対してPCが1台あれば十分です。
オンラインで受講される方は
「Zoom」「Teams」などのオンラインツールが利用できる環境があればいいと考えます。
テキストは
IT研究所株式会社が作成したものをPDFで提供します。
必要なソフトウェアやセットアップの方法も
PDFで事前配布します。
みんなが楽しみながらIT・プログラミングの知識を習得してほしいと思いますし
将来のIT技術者を研修や動画コンテンツを通じて
育成していきたいと考えています。
私は日本全国に多くのIT技術者を育成できる研修を目指していきたいです。
そして一人でも多くの受講者に受講してもらい理解してもらえる研修を行いたいと思っています。